海通金工—基于机器学习和知识图谱的行业轮动
时间:2020 年 07 月 21 日
分析师:冯佳睿、张振岗
摘要
研究背景。我们在之前的行业轮动系列报告中挖掘了几大类的行业因子,例如,量价、宏观、情绪面、高频因子、预期基本面、历史基本面、公募基金观点等。 这些因子通常可以分为两类:行业本身的特征以及基于共同外生变量变动的行业预期收益,但这两类因子都没有考虑行业之间的关联性。因此,在本篇报告中, 我们从另一个角度研究行业收益的可预测性:相关行业的滞后收益率。
理论基础。投资者处理信息的能力有限,当某个行业出现信息或冲击时,专门从事相关行业的投资者可能也无法迅速把握冲击的全部影响。因此,信息会逐渐在各个行业间扩散,导致不同行业的股票价格先后响应。这一现象构成了某些行业滞后收益率可以预测其他行业未来收益率的理论基础。
策略逻辑。采用除目标行业外其他行业的滞后收益率,与下一期目标行业收益率构建回归模型。如果只是使用普通最小二乘(OLS)选择全部行业进行回归,容易产生过拟合;如果只选择几个行业因子,又存在很强的主观性。为了解决这些不足,我们引入了机器学习和知识图谱两种方法。
基于Post-Lasso的行业轮动策略。**模型包含两个步骤:(1)用 Lasso 方法筛选预测变量;(2)用上一步中的预测变量建立回归模型。在 2010/1-2020/4 期间, 由此得到的行业轮动策略的多头年化超额收益为 5.36%,空头年化超额收益为 -6.38%,多空收益为 11.57%。策略因子化后的 IC 为 0.07,T 值在 3 以上。
用客户-供应商关系构建 A股行业知识图谱。**我们将 FactSet 供应链数据中 A 股上市公司的客户-供应商关系,嵌入 Input-Output 网络,构建 A 股行业的知识图谱。利用知识图谱提供的先验知识,可以确定行业收益率的领先-滞后关系。
基于行业知识图谱的轮动策略。首先,在每个月末根据关系网确定每个行业的预测变量。其次,以 24 个月为窗宽,建立目标行业收益率和预测变量滞后收益率 的线性回归模型。最后,预测最新一期的目标行业收益率。在 2017/1-2020/4 期 间,由此得到的行业轮动策略多头年化超额收益为 8.44%,空头组合的年化超额收益为-10.84%。多空收益为 19.44%,最大回撤为 10.53%。
研究背景
我们在之前的行业轮动系列报告中挖掘了几大类的行业因子(见下图),例如,量价、宏观、情绪面、高频因子、预期基本面、历史基本面、公募基金观点等。这些因子通常 可以分为两类:行业本身的特征以及基于共同外生变量变动的行业预期收益,但这两类 因子都没有考虑行业之间的关联性。
图1 行业轮动因子池
{w:100}
实际上,如果市场是完全理性、无摩擦的,那么滞后行业的收益率是不应该有预测 效果的。但真实的情况是,投资者处理信息的能力有限,当某个行业出现信息或冲击时, 专门从事相关行业的投资者可能也无法迅速把握冲击的全部影响。因此,信息会逐渐在 各个行业间扩散,导致不同行业的股票价格先后响应。这一现象构成了某些行业滞后收 益率可以预测其他行业未来收益率的理论基础。
如果想要应用这一特征,最简单的方法就是直接采用除目标行业外所有其他行业的 滞后收益率,与下一期目标行业收益率构建回归模型。但由于回归模型中潜在的预测因 子过多,例如,可能需要几十个行业过去 12-36 个月的历史收益率作为预测因子。使用 普通最小二乘(OLS)估计可能会存在以下两个问题。如果选择全部行业,容易产生过 拟合;如果只选择几个行业因子,存在很强的主观性。为了解决这些不足,我们引入了 机器学习和知识图谱两种方法,这也是本篇报告的核心之处。
基于 Post-Lasso 的行业轮动策略
2.1 Post-Lasso 方法
本文采用 Post-Lasso 方法筛选有预测效果的行业,并以此为基础预测目标行业的未来收益。
Lasso 回归,全称 Least absolute shrinkage and selection operator,是一种压缩估 计,也被称作线性回归的 L1 正则化。相比于普通最小二乘估计,它通过构造一个惩罚 函数,在变量众多的时候,能快速有效地提取重要变量,简化模型。其目标函数的表达 式如下:
{w:100}
相比于直接采用 Lasso 估计参数,Post-Lasso 方法避免了过度收缩的问题,可以更 准确地获得滞后行业收益中的预测信号。下式中的标记 M 表示 Post-Lasso 模型的特征 集合与对应的参数估计。
{w:100}
2.2 Post-Lasso 的行业筛选
在下文的测试中,我们均采用中信一级行业,回溯期为 2010 年 1 月至 2020 年 4月。根据 Post-Lasso 方法,在 t 月末,选择 1 到 t-1 时刻的数据(至少 60 个月)训练 Lasso 模型。下图列示的是各目标行业由 Lasso 模型选到的相关行业的平均数量。
{w:100}
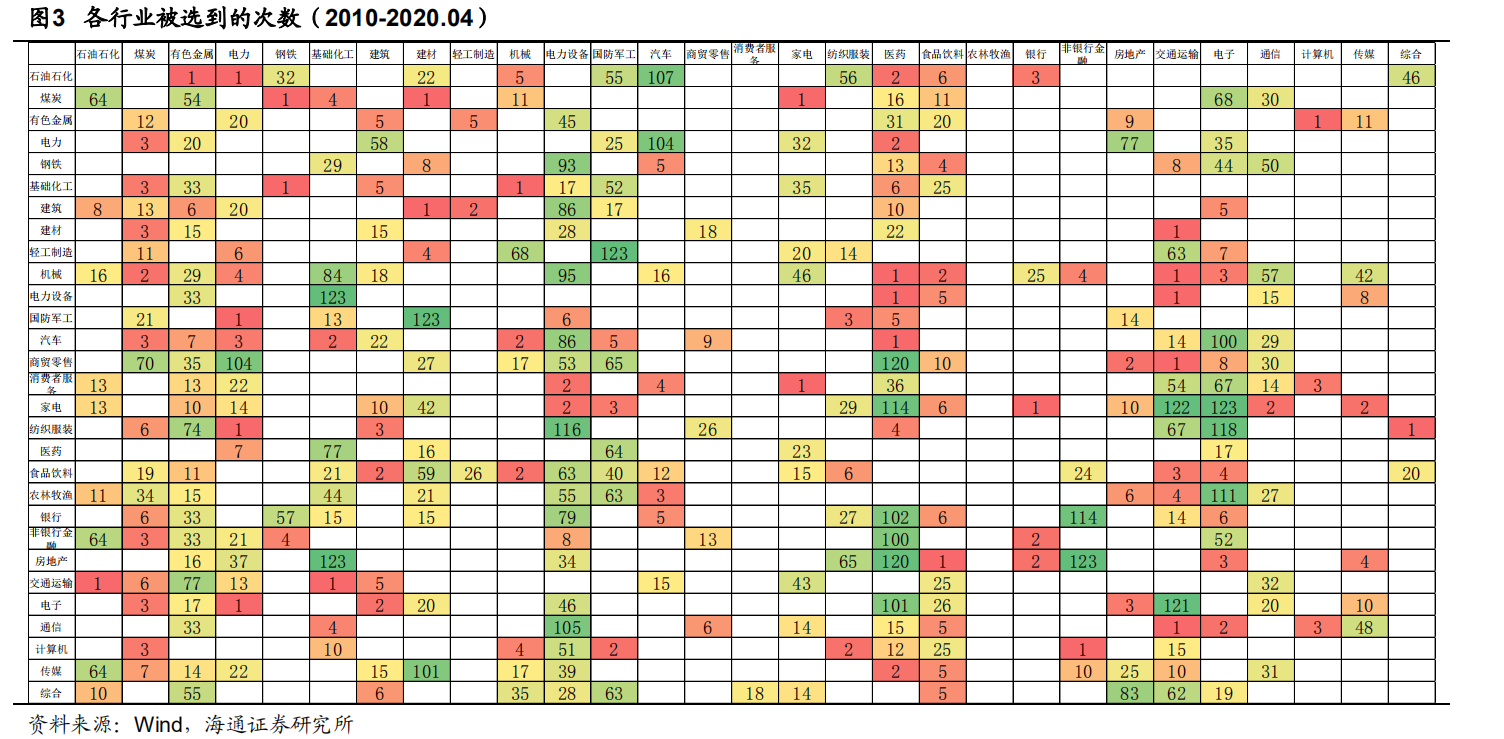
下图展示的是各行业被选到的次数,每一列代表若将该行业作为目标行业,Lasso 模型能选到哪些相关行业,历史上选到的次数是多少。例如,第一列的目标行业是石油 石化,有 64 次选择了煤炭行业的滞后收益率作为因子,8 次选择建筑行业、16 次选择 机械行业,等等。
若横向汇总每个行业被选到的次数,则可大致了解该行业在整个市场中的位臵。以 银行行业为例,有 13 个行业曾经选择其为相关行业因子,总共被选到的次数高达 479 次。虽然这个结果来自于纯粹的数据挖掘,但依然具有较强的经济意义,因为许多行业 均依赖银行作为融资中介机构。此外,房地产行业总计被选中 528 次,和银行一同在 29 个行业中位列前五。
![]()
{w:100}
2.3 未选到行业的填补方法
{w:100}
我们发现,回测过程中部分目标行业存在未选到任何相关行业的情况。例如,下图 中,农林牧渔、计算机和消费者服务等行业都有较多的时间点未选择任何行业作为预测 变量。针对这种情况,我们需要采用其他方法预测目标行业未来一个月的收益。
{w:100}
{w:100}
{w:100}
2.4 Post-Lasso 行业轮动策略的表现
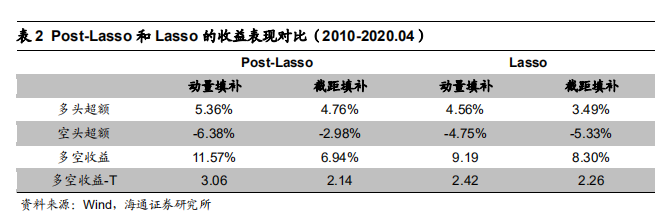
下图展示了 Post-Lasso 行业轮动策略的表现,未选到行业时采用动量填补法。其中, 多头和空头分别取预测收益率最高和最低的 5 个行业。整体来看,分组收益具有单调性, 多头相对基准以及多空的收益表现都较为稳定。多头年化超额收益为 5.36%,空头年化 超额收益为-6.38%,多空收益为 11.57%。
{w:100}
{w:100}
![]()
{w:100}
2.5 参数敏感性分析
{w:100}
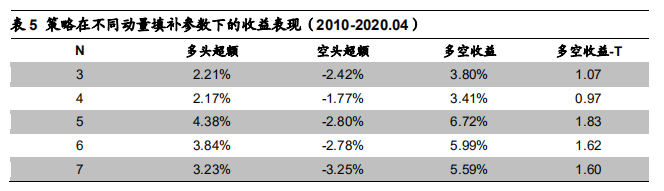
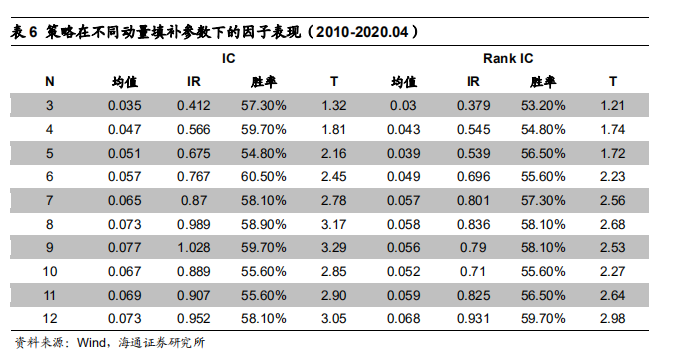
机器学习方法的一个潜在问题是对参数的过度优化,本文的 Post-Lasso 模型也有两 个主要参数,分别是初始的训练期长度和动量填补的时间跨度。
以下两表展示的是不同的初始训练期下,策略的多空收益和 IC 表现。整体来看,从 36 个月到 144 个月,策略的多空收益及 IC 均显著大于零。这表明,策略对参数——初 始训练期的敏感性并不高。上文选择 60 个月作为参数,算不上是完全数据挖掘的结果。 但也应该注意到,初始训练期越长,策略的多空收益和 IC 都相对更高。这样的结果同样 符合逻辑,毕竟对于机器学习而言,60 个月的数据并不算长。
{w:100}
{w:100}](/wiki/api/attachments.redirect?id=3c449150-30f8-4934-82c4-f0b6a5925771)动量填补法采用的是 t-N 到 t-1 月的行业收益均值。如下表所示,当 N 在 8 到 12 之间变化时,策略多空收益和因子 IC 都较为稳定,T 值均在 2 以上。
![]()
{w:100}
{w:100}
2.6 和简单动量策略的对比
{w:100}
{w:100}
当 Post-Lasso 模型未选到任何行业作为预测变量时,我们使用了目标行业自身的动 量因子作为填补。那么,不妨比较一下 Post-Lasso 模型和完全的动量策略,考察引入其 他行业的收益率作为预测因子是否有必要。
首先,我们计算了 Post-Lasso 模型和 3、6、12 个月动量策略的相关性,结果如下 表所示。不出所料,Post-Lasso 模型和动量策略正相关。而且,随着动量策略的因子计 算周期的拉长,相关性也越高。这是由于当 Post-Lasso 模型无预测变量时,我们采用的 处理方法所致。
{w:100}
{w:100}
{w:100}
显然,Post-Lasso 模型在任何一个方面都显著优于简单的动量策略。对比有部分因 子重合的 Post-Lasso 模型和 12 个月动量策略,前者的年化收益为 9.57%,夏普比率为 0.35,IC/RankIC 在 0.07 附近,对应的 t 统计量约为 3,胜率也接近 60%;而后者的年 化收益为 7.38%,夏普比率为 0.26,IC/RankIC 不到 0.05,对应的 t 统计量小于 2,胜 率也将将超过 50%。
基于客户-供应商关系的行业轮动策略
上文介绍的 Post-Lasso 模型完全通过数据驱动,得到行业收益率之间的领先-滞后关系。在实证过程中,我们也发现了很多难以解释,甚至不合逻辑的结果。例如,电子行业经常选择农林牧渔行业为预测变量。因此,建立行业关联关系更好的方法是,基于 行业内在的经济逻辑,总结相关的先验知识,并固定成知识图谱,然后再为目标行业挑 选预测变量。
3.1 从投入-产出关系到行业贸易网络
一类常用的建立行业之间联系的方法是基于投入产出(Input-Output,I-O)关系得 到行业贸易网络(Trade Network)。例如,国家统计局公布的投入产出表就是一个很好 的起点。下图给出了投入产出表的部分结构。
{w:100}
根据上表,我们可以建立两种行业网络——拉动型产业复杂网络(Pulling Industry Complex Network)和推动型产业复杂网络(Pushing Industry Complex Network)。
其中,拉动型网络是基于下游产业对上游产业的拉动作用建立的,需要从投入产出 表的纵向获取产业间的关联关系。即,假设存在 N 个行业(投入产出表中的行业划分), xij 表示第 i 个行业对第 j 个行业的中间投入。则可计算行业 i 对行业 j 的中间投入在所有 行业对行业 j 中间投入总和中的占比,具体形式如下:
{w:100}
在本文中,我们选择 1/(行业个数 N-1)为存在关联关系的阈值。 即,PULLij 大于阈值时,认为行业 i 和 j 互相关联,在网络图中表示为存在连接边;否则, 两个行业不存在连接边。为了便于数据处理,进一步把这种形态的网络转化为一个 N*N 的拉动矩阵。当行业 i 和 j 存在连接边时,则该矩阵第 i 行、第 j 列的元素为 1;否则, 元素为 0。
与拉动型网络对应的则是推动型网络,它基于上游产业对下游产业的推动作用建立, 需要从投入产出表的横向获取产业间的关联关系。即,行业 i 对行业 j 的中间投入在行业 i 对所有行业中间投入总和中的占比,具体形式如下:
{w:100}
{w:100}
{w:100}
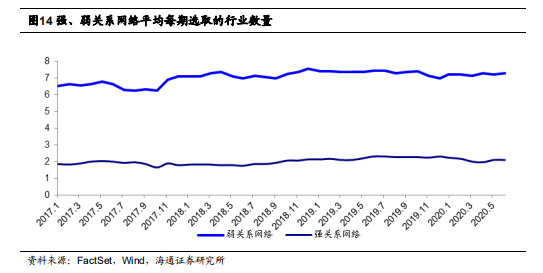
有了这两种汇总网络,我们就可以直观地确定某一目标行业的预测变量,即和它有 关联关系的行业的滞后收益率。举例来说,要预测 2020 年 4 月的卫生和社会工作行业 的收益,首先是从关系网中读取它的关联行业,如强关系网络中的化学产品和专用设备。 其次,用这两个行业的滞后收益率作为自变量,卫生和社会工作行业当期收益率作为因 变量建立线性回归模型。和前文使用 Lasso 模型选取预测变量不同,基于贸易网络的方 法源于对行业之间投入-产出关系的归纳,是通过社会经济基本面的运行逻辑来筛选预测变量。理论上,其效果应当优于单纯的数据挖掘。
然而,如果我们想要把上述由统计局公布的投入产出表形成的行业贸易网络,用于 指导实际的行业轮动,可能会存在以下几个问题。
(1)投入产出表的行业划分与常用的上市公司行业分类标准,如,申万、中信一 级行业不同。因此,如果要以后两者之一为基础构建行业轮动策略,则需要手动将两种 行业分类重新匹配,不仅费时费力,而且具有很强的主观性。
(2)投入产出表的更新频率较低。我国一般每五年编制一版投入产出表,这意味 着由此建立的行业贸易网络,可能 5 年都不会发生变化。在此期间,某一目标行业的预 测变量也将是长期不变的。这似乎较难适应当前的经济环境和日新月异的行业变化。
(3)投入产出表的披露滞后期过长。例如,《2017 年投入产出表》于 2019 年 9 月 发布,由此得到的行业关联关系也将落后至少 2 年的时间。
为了克服上述问题,获得更新频率高、数据时效性强且和常用分类方式一致的行业 贸易网络,本文在保留网络构建方法的基础上,用 FactSet 的供应链数据代替投入产出 表,建立 A 股市场的行业关系网,并设计相应的行业轮动策略。
3.2 基于上市公司的客户-供应商关系构建行业贸易网络
FactSet 供应链数据库中 A 股上市公司的客户-供应商关系,实际上类似于前文提到 的投入-产出关系。因此,我们只需将个股的客户-供应商关系映射到行业,并以每个客 户的营收作为中间投入,汇总得到行业两两之间的中间投入,就可以生成新的行业投入 产出表。进而就可以按照上一节介绍的方法得到强/弱关系网络,筛选预测变量。整个流 程如下图所示。
{w:100}
{w:100}
![]()
{w:100}
3.3 行业轮动策略
{w:100}
有了行业关系网络,轮动策略的设计也变得较为简单。首先,在每个月末根据关系 网确定每个行业的预测变量。其次,以 24 个月为窗宽,建立目标行业收益率和预测变 量滞后收益率的线性回归模型。最后,预测最新一期的目标行业收益率,从大到小排序 后选取最高(低)的 5 个行业形成等权重的多(空)头组合。
下图给出了基于强关系网络的行业轮动策略的表现。其中,多头组合相对全行业平 均这一基准的年化超额收益为 8.44%,空头组合的年化超额收益为-10.84%。多空收益 为 19.44%,最大回撤为 10.53%。
{w:100}
下图是利用弱关系网络构建的行业轮动策略的收益表现。其中,多头组合的年化超 额收益为 1.67%,空头组合的年化超额收益为-6.55%。多空收益为 7.98%,最大回撤为 9.91%。相对而言,策略的空头效应更为突出。
{w:100}
{w:100}
总结
由于信息传递存在滞后性,某些行业的滞后收益率可用来预测其他行业的预期收益。实现这一目标的一种最简单的做法是将所有行业的历史收益率放入回归模型,但过高的维数会导致 OLS 估计的效率快速降低。因此,对预测变量进行筛选是提高模型预测能力的有效途径。本文尝试了机器学习中的 Post-Lasso 模型和引入含先验信息的知 识图谱两种方法。
Post-Lasso 模型包含两个步骤:(1)用 Lasso 方法筛选预测变量;(2)用上一步 中的预测变量建立回归模型。在 2010/1-2020/4 期间,由此得到的行业轮动策略的多头 年化超额收益为 5.36%,空头年化超额收益为-6.38%,多空收益为 11.57%。
根据 FactSet 供应链数据中的 A 股上市公司的客户-供应商关系,我们建立了行业 之间的强关系网络。在 2017/1-2020/4 期间,由此得到的行业轮动策略多头年化超额收 益为 8.44%,空头组合的年化超额收益为-10.84%。多空收益为 19.44%,最大回撤为 10.53%。