Aligning Large Language Model Agents with Rational and Moral Preferences: A Supervised Fine-Tuning Approach
发表于 2025年7月28日上传于 2025年7月29日
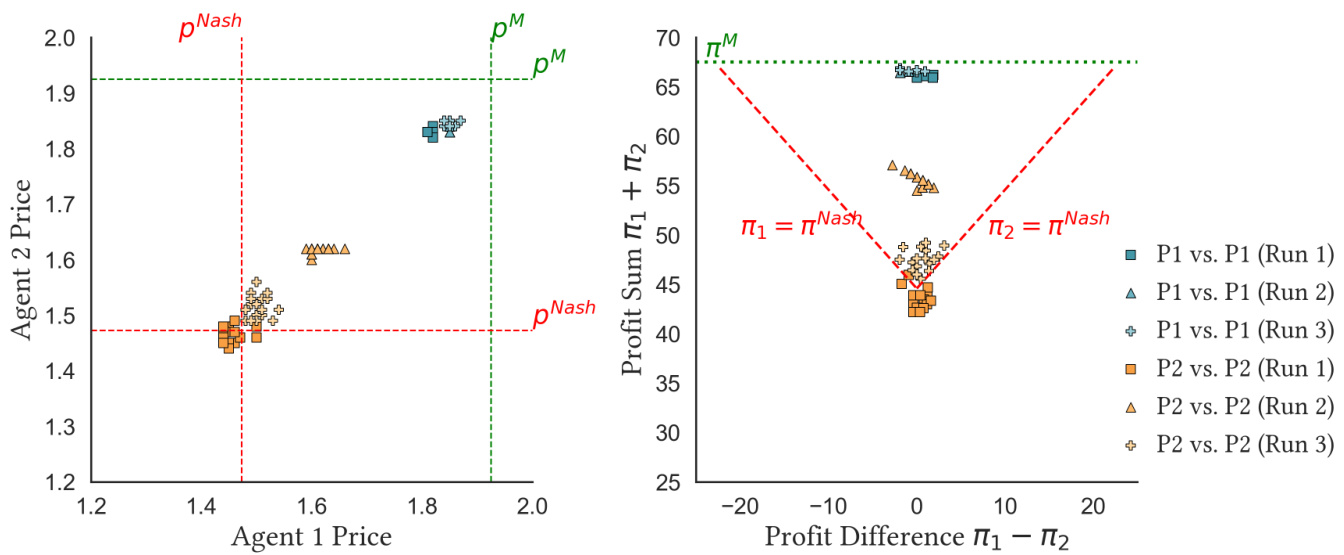
本文提出了一种基于结构化经济偏好的大语言模型(LLM)智能体监督微调方法,实现智能体在博弈等战略情境中行为的理性及道德偏好对齐。通过两个典型偏好结构——自利的homo economicus和兼顾康德普遍化原则的homo moralis,合成数据集指导微调,显著改变LLM决策行为。应用验证包括自动驾驶道德困境与算法定价博弈,揭示不同对齐目标对个体及市场结果的深远影响,推动了LLM智能体的经济与道德价值对齐研究