Demand Estimation with Text and Image Data
发表于 2025年10月12日上传于 2025年10月14日
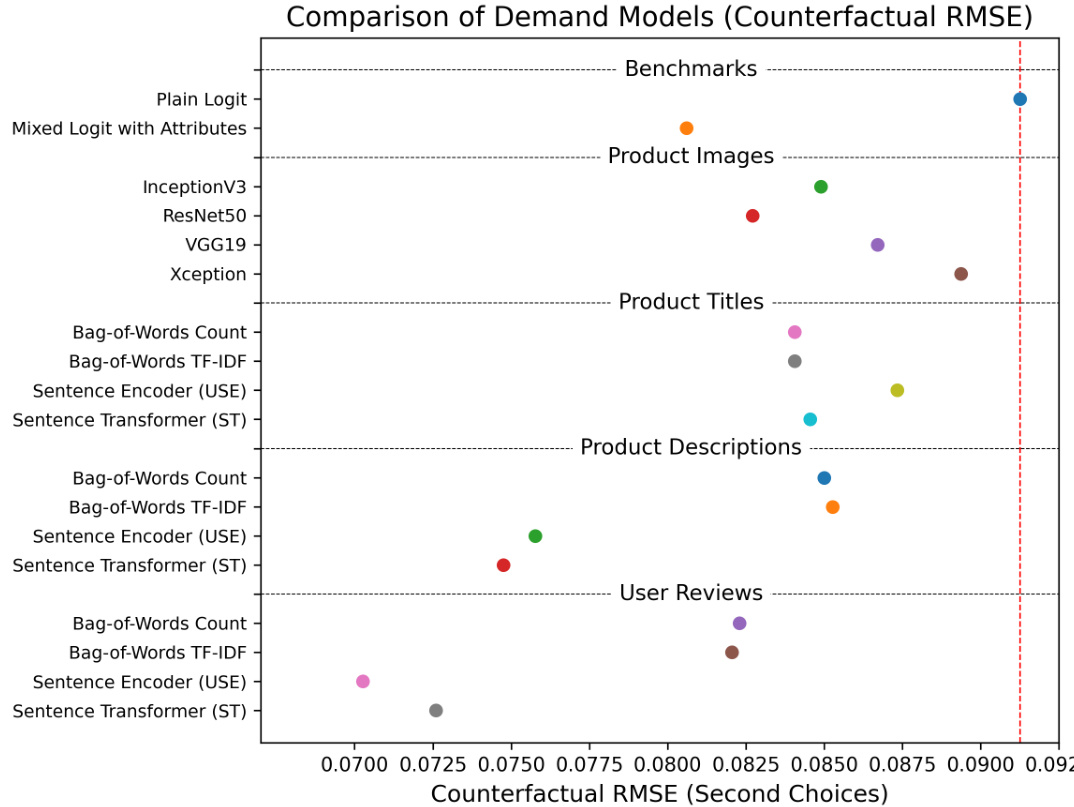
本文提出一种利用产品文本和图像非结构化数据,通过预训练深度学习模型提取嵌入向量,并结合主成分分析和混合Logit模型,准确估计产品需求和替代模式。实验和实证数据均显示该方法优于传统基于属性的需求模型,显著提升二选项预测的准确度,在反事实定价和合并模拟中表现突出。
本文提出一种利用产品文本和图像非结构化数据,通过预训练深度学习模型提取嵌入向量,并结合主成分分析和混合Logit模型,准确估计产品需求和替代模式。实验和实证数据均显示该方法优于传统基于属性的需求模型,显著提升二选项预测的准确度,在反事实定价和合并模拟中表现突出。
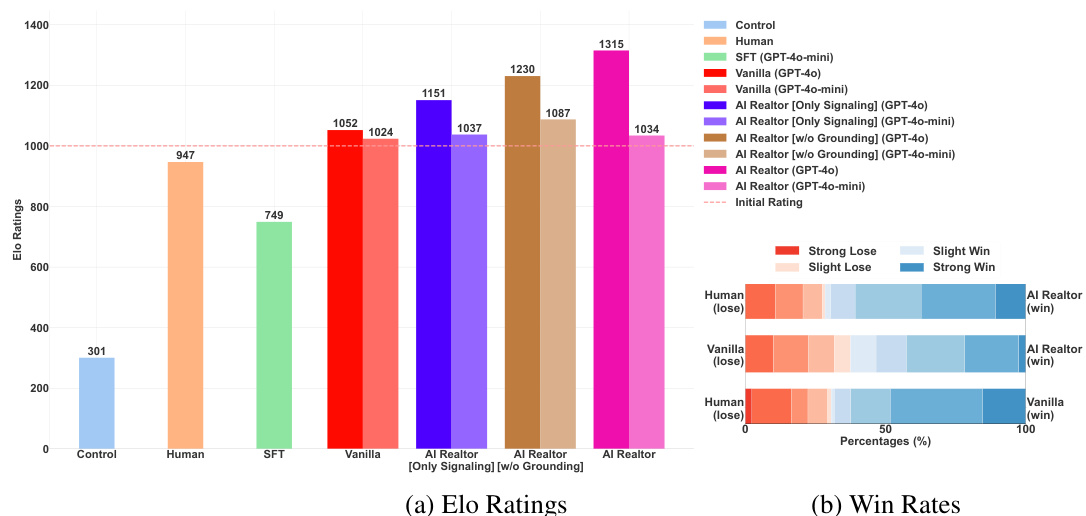
本报告提出了基于大语言模型(LLM)的智能代理框架,实现对房地产营销文本的自动化生成。框架集成了三大模块:特征定位(Grounding)、个性化(Personalization)与营销策略(Marketing),能结合用户偏好生成既具说服力又保证事实准确的产品描述。系统在人类主观评价中以70%的胜率超越专业经纪人,且内容真实性无明显偏差,展示了自动化精准营销的广阔潜力 。

本论文提出了一个包含零售、养老、机构和对冲基金四类异质交易者的模拟数据生成过程,基于扩展CAPM和CPI意外冲击,采用软最大离散选择模型模拟交易规模选择。结果显示,信息更充分且风险偏好较低的交易者持仓更大、财富更高,零售投资者反应迟缓且分布更分散,市场流动性放大了订单流对宏观冲击的敏感性。该框架为宏观公布期的订单流动态分析提供了透明基准,并具备基于实时数据反推消息影响的潜力 。
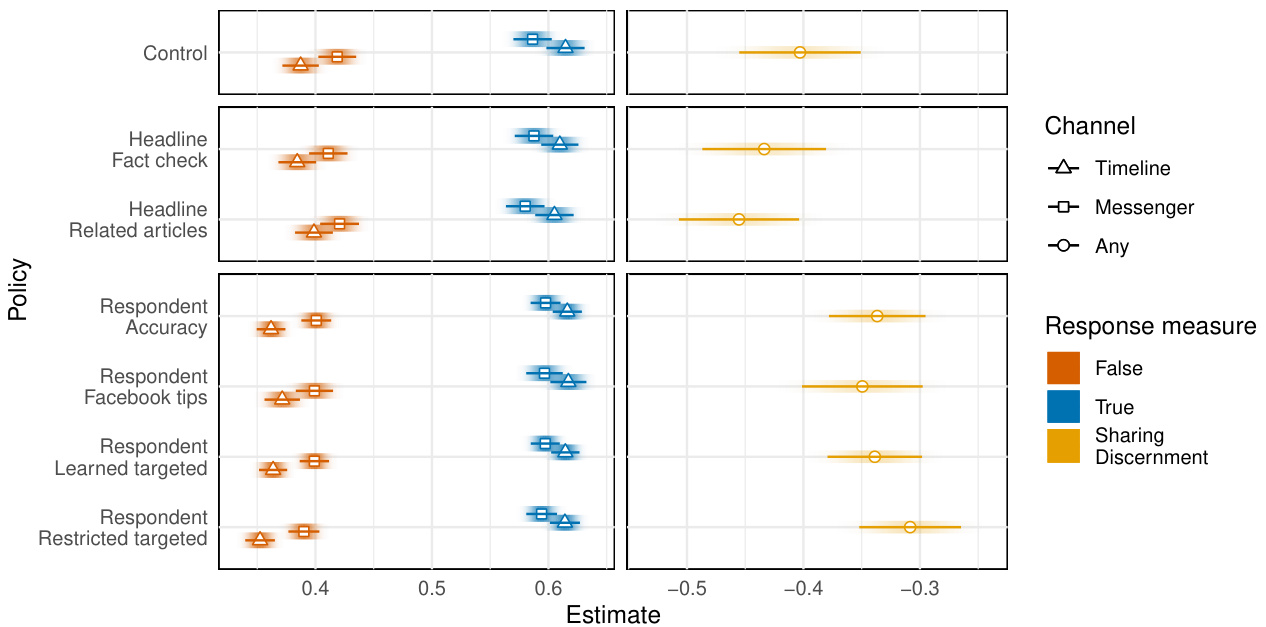
本研究针对肯尼亚和尼日利亚社交媒体用户开展实验,评估不同干预措施在减少COVID-19错误信息传播而不影响真实信息分享方面的效果。通过两阶段设计,首次采用40种多因素组合和自适应分配算法筛选最优策略,随后进行精确效果评估。结果显示,警示标签和相关文章推送无显著影响,而“准确性提示”显著降低误传意图达4.9%,未影响真实信息分享,表明低成本、可扩展干预具备全球推广潜力
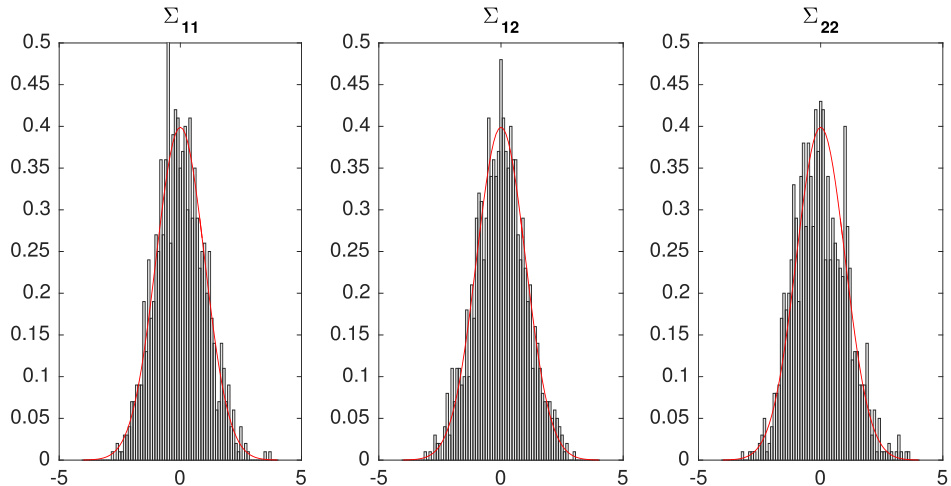
本文提出了一种多变量实现的拟最大似然(QML)估计方法,用于处理因市场微观结构噪声和非同步交易引起的股价协方差估计难题。利用Kalman滤波与EM算法优化似然函数,新估计量保证正定性、利用全部异步数据且具有一致性和渐近混合正态分布。因子模型版本支持高维资产,且两种估计均达到有效收敛速率。蒙特卡洛模拟与实证研究均显示该方法在估计精度及大尺度资产组合分析中具有优势,尤其在非均衡数据情形下表现突出