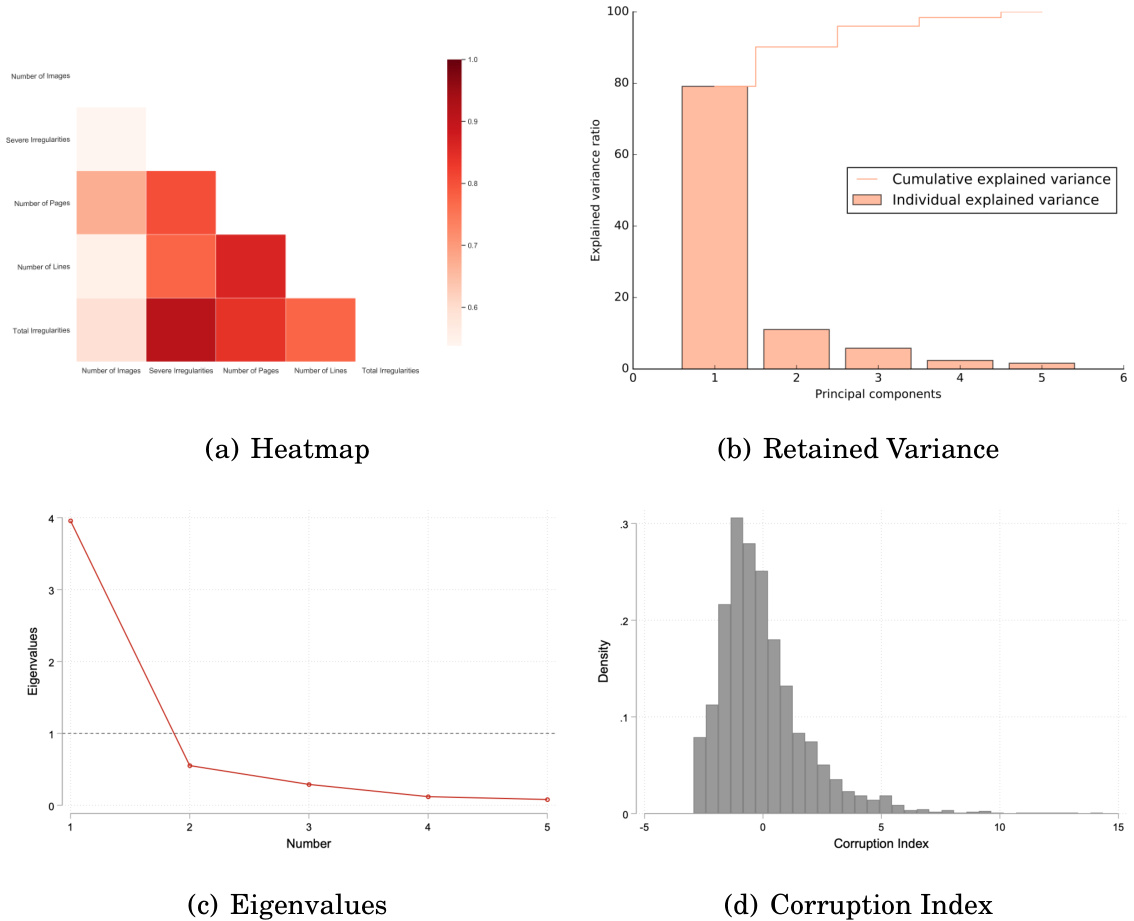
Measuring Corruption from Text DataCentralEU发表于 2025年11月23日上传于 2025年12月11日本文提出一种可重复的文本测量方法:通过词典识别审计报告中的“严重违规”与其他文本特征,结合主成分分析(PCA)构造腐败严重性指数;该指数在与人工编码的高一致性样本中能解释71%–73%的手工腐败计数变异,并对 CGU 官方严重违规分类、城市特征相关性和监督学习替代方法均表现稳健,从而证明了方法的有效性与可扩展性