Deep catastrophic-risk-aware reinforcement learning
发表于 2026年10月21日上传于 2026年10月21日
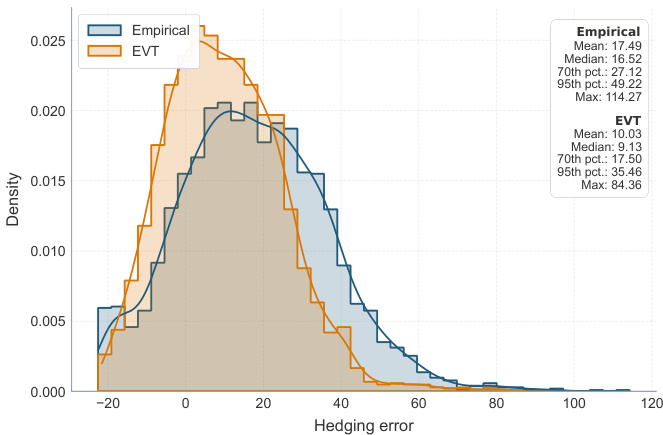
本文将极值理论(EVT)与风险敏感强化学习结合,针对高置信度CVaR估计中极端样本稀缺的问题,利用峰值超阈值法、广义帕累托分布和矩估计构建可微尾部风险目标,并通过自动微分训练神经网络策略。在深度对冲实验中,EVT策略在一般市场情景下与经验CVaR策略表现相近,但在极端市场情景下显著降低对冲损失,且该优势在不同训练样本规模下均保持。
本文将极值理论(EVT)与风险敏感强化学习结合,针对高置信度CVaR估计中极端样本稀缺的问题,利用峰值超阈值法、广义帕累托分布和矩估计构建可微尾部风险目标,并通过自动微分训练神经网络策略。在深度对冲实验中,EVT策略在一般市场情景下与经验CVaR策略表现相近,但在极端市场情景下显著降低对冲损失,且该优势在不同训练样本规模下均保持。
本论文对深度对冲是否属于强化学习进行澄清,主张其为蒙特卡洛策略梯度、演员-唯一更新的RL实现。尽管缺少价值函数、贝尔曼方程、TD学习以及显式探索,但符合RL的广义定义,RL不仅限于价值基或TD框架,因而深度对冲应归于RL范畴,与Sutton与Barto的分类保持一致。
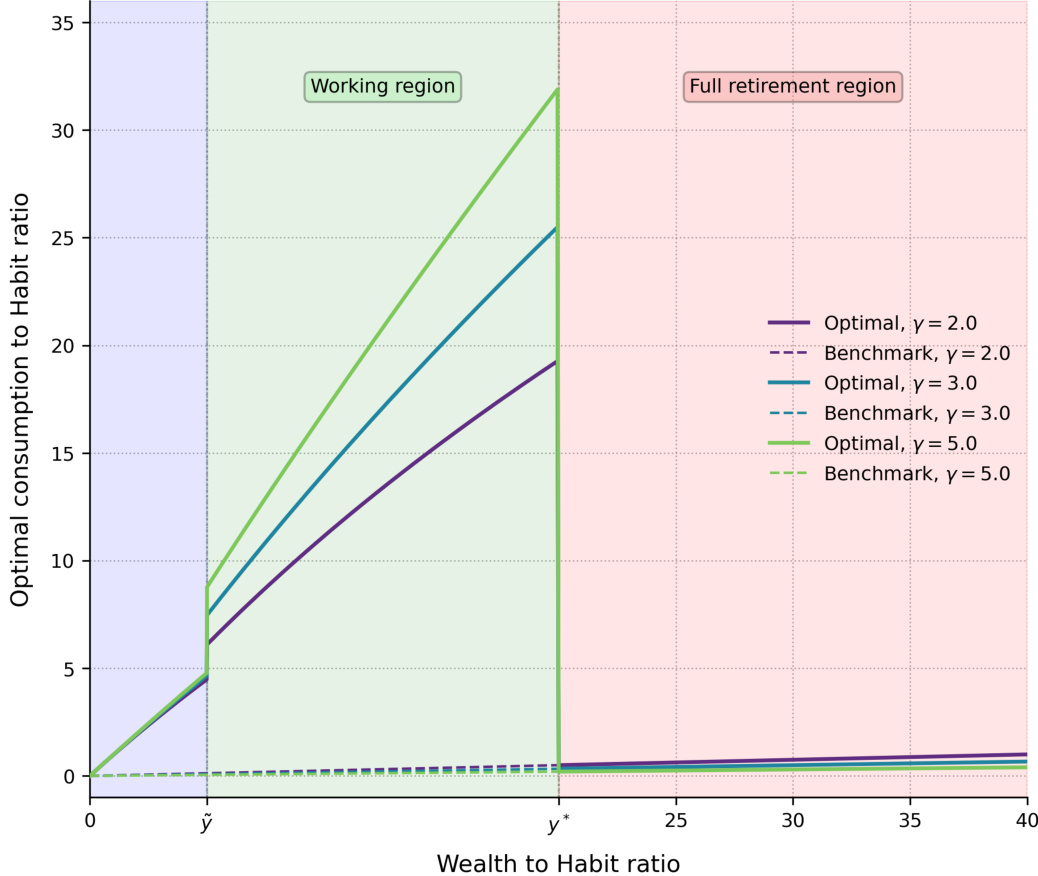
本文构建一套连续时间生命周期模型,将习惯形成、内生劳动供给与不可逆年金化(annuitization)决策以随机控制+最优停时问题统一刻画,并通过HJB变分不等式与财富/习惯比的维度约简得到半解析解,揭示:低财富/高习惯时通过劳动“防守性供给”维护消费标准;财富中间区进入“全力工作以实现退休”阶段;年金化时出现突发去风险,同时主观寿命信念显著影响是否以及何时年金化,从而为低年金需求提供行为学解释
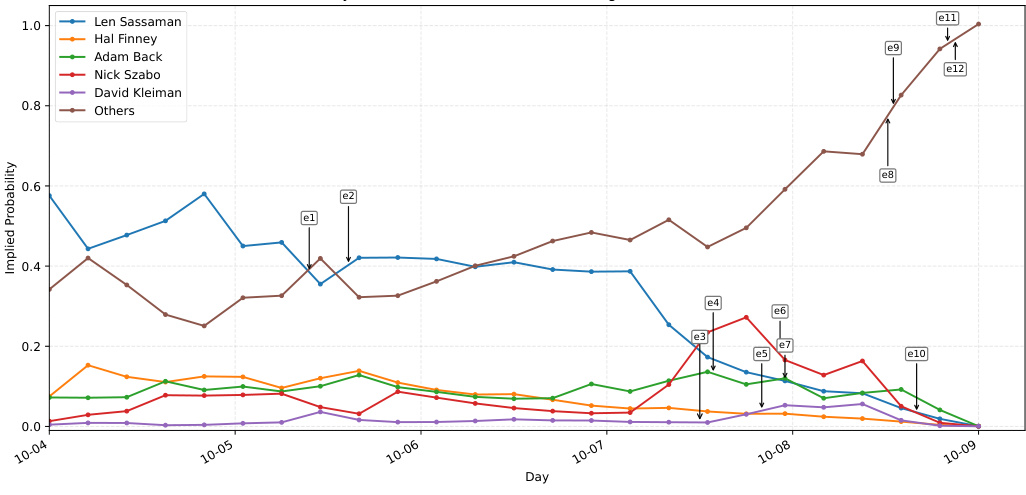
本报告系统化梳理去中心化预测市场(DePMs)的市场微观结构,提出包含八个模块的流程(基础设施、市场主题、份额结构与定价、初始化、交易、裁决、结算与存档),并比较了早期设计(Truthcoin/Princeton)与现代实现(如Polymarket)的关键差异与权衡,指出包括AMM适配、MEV、仲裁投票以及可验证市场谓词等若干研究空白,为后续理论与工程工作提供路线图
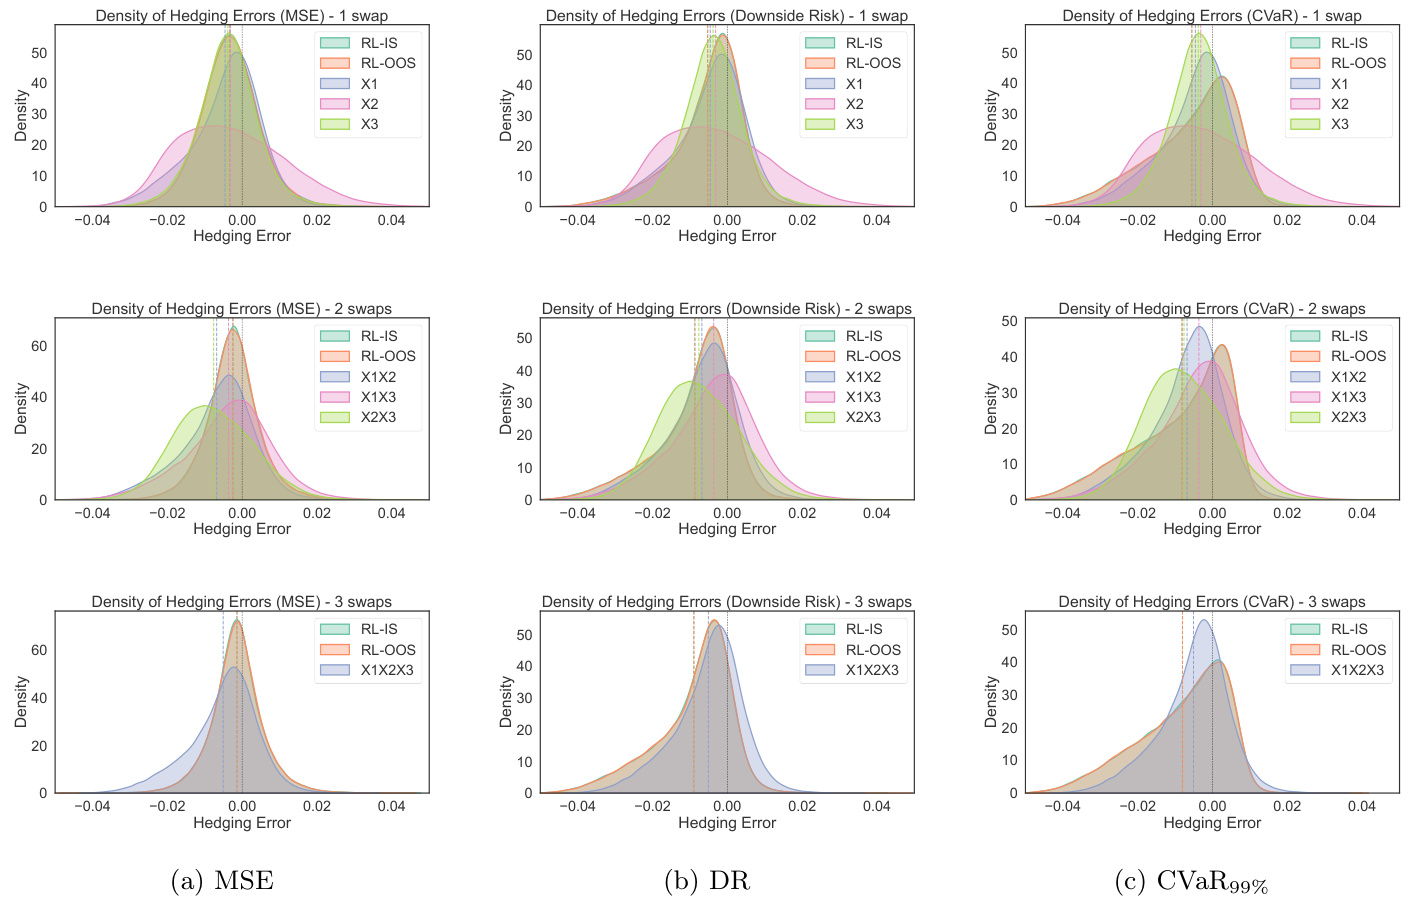
本文提出并评估基于深度强化学习的“deep hedging”框架,用于对欧式 payer swaption 进行动态对冲,并与传统以因子敏感度(rho)为基础的对冲方法比较。研究在离散时间三因子无套利 Nelson–Siegel 模型下进行蒙特卡洛实验,分别以 MSE、下行风险(DR)和 CVaR 为目标训练对冲代理,结果显示:使用两个互补期限的掉期作为对冲工具可实现接近最优的对冲效果;RL 策略通过动态调整对各因子的暴露在多数情形下显著优于 rho-hedging,且在一定程度的模型误设情况下仍更具稳健性;不同目标函数会诱发不同的对冲风格(例如 CVaR 目标降低尾部风险而 MSE 目标提升整体精确度)
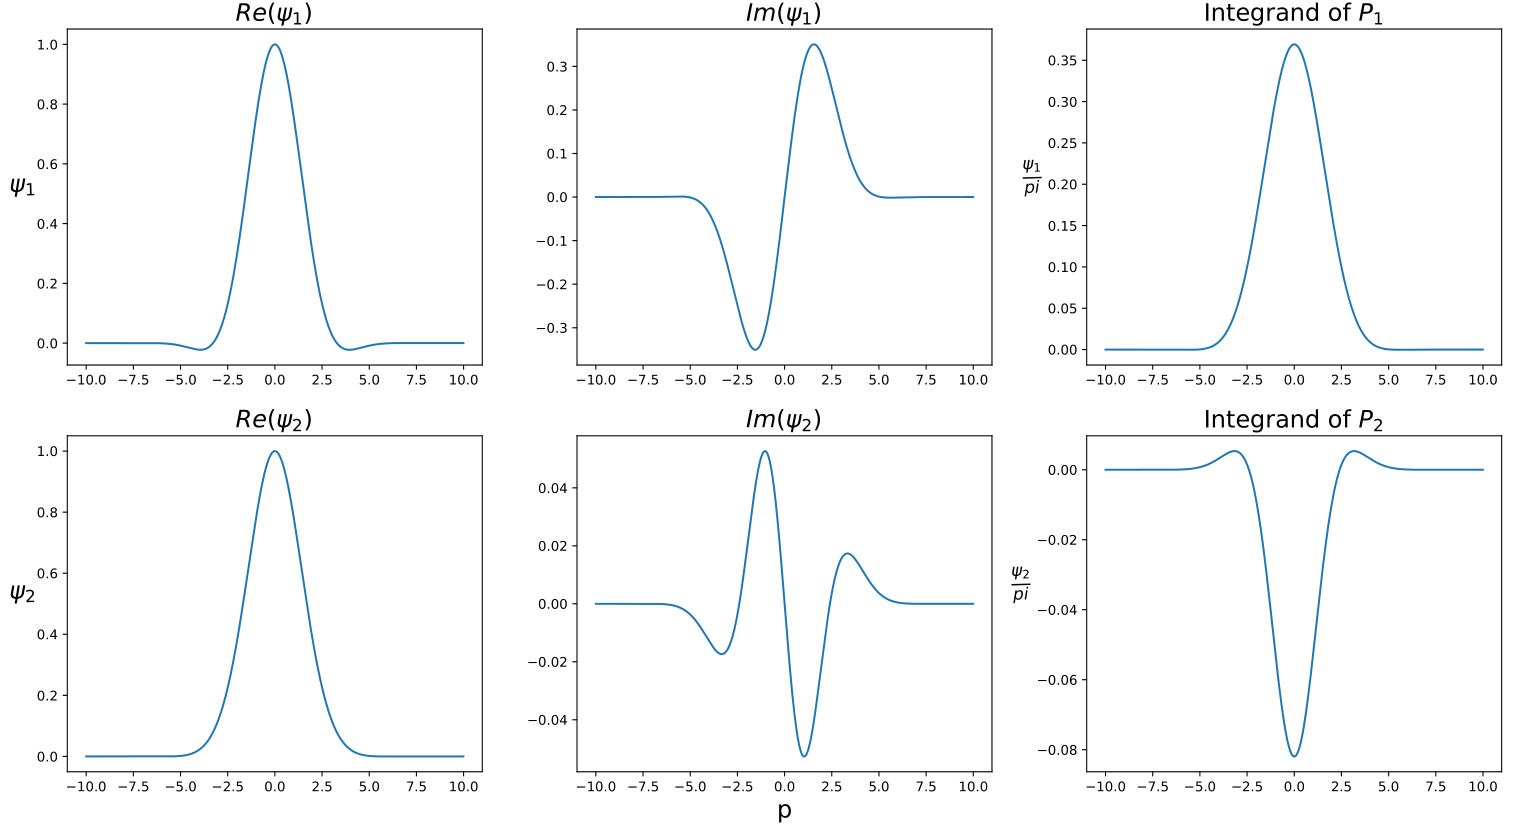
提出了一种基于可微联合特征函数的卷积–FFT(CFFT)欧式期权定价方法,消除了经典Heston特征函数的分支/复对数不连续性,并给出关于截断误差与离散化误差的显式解析界(包括指数截断项与多项式离散项),数值实验验证了理论收敛速率且在计算成本上具有竞争力