Risk-Adjusted Harm Scoring for Automated Red Teaming for LLMs in Financial Services
发表于 2026年3月12日上传于 2026年3月12日
本文提出基于金融领域的FinRedTeamBench、基于三模评判的自动化多轮红队流程与风险敏感指标RAHS,用以衡量LLM在银行/金融/保险场景下的越狱风险与操作性披露严重性,并验证高采样随机性与多回合交互会同时提升越狱成功率与披露严重度
本文提出基于金融领域的FinRedTeamBench、基于三模评判的自动化多轮红队流程与风险敏感指标RAHS,用以衡量LLM在银行/金融/保险场景下的越狱风险与操作性披露严重性,并验证高采样随机性与多回合交互会同时提升越狱成功率与披露严重度
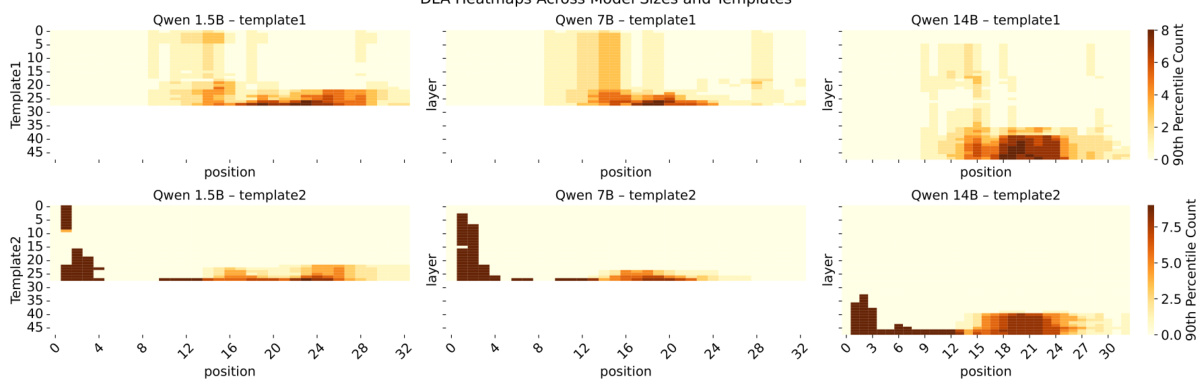
本研究提出了首个针对金融领域大语言模型(LLM)Qwen2.5的统一检测框架,量化并揭示了二元金融决策中的位置偏差及其机理来源。结果显示位置偏差普遍存在且随模型规模和提示设计变化而波动,风险类任务中的偏差尤为顽固。通过机制可解释方法,研究定位偏差主要集中于模型的中后层及特定注意力头,提示了针对性去偏策略的方向 。

本报告首次系统性地研究了开源Qwen大语言模型在金融投资中的表示偏差,发现模型偏好规模较大、估值高的企业,且行业分类对偏好影响显著。模型信心与基本面指标(如自由现金流)高度相关,但风险指标呈负相关,表明对低风险企业偏好更强。研究提出了基于行业的校准和分类条件评估协议以提升模型公平性和安全性 。
本报告提出FinReflectKG - EvalBench,针对SEC 10-K文件中的金融知识图谱提取任务,设计了首个多维度评价基准和框架。通过对单述、复述及反思三种提取模式在忠实性、精确性、相关性和全面性方面的对比评测,发现反思模式在全面性、精确性和相关性上表现最好,单述模式忠实性最高。报告还创新采用严格偏差控制和提交-说明评判协议提升评估稳定性和可解释性,为金融知识图谱在合规、风险管理等应用提供可信赖的研究基础 。
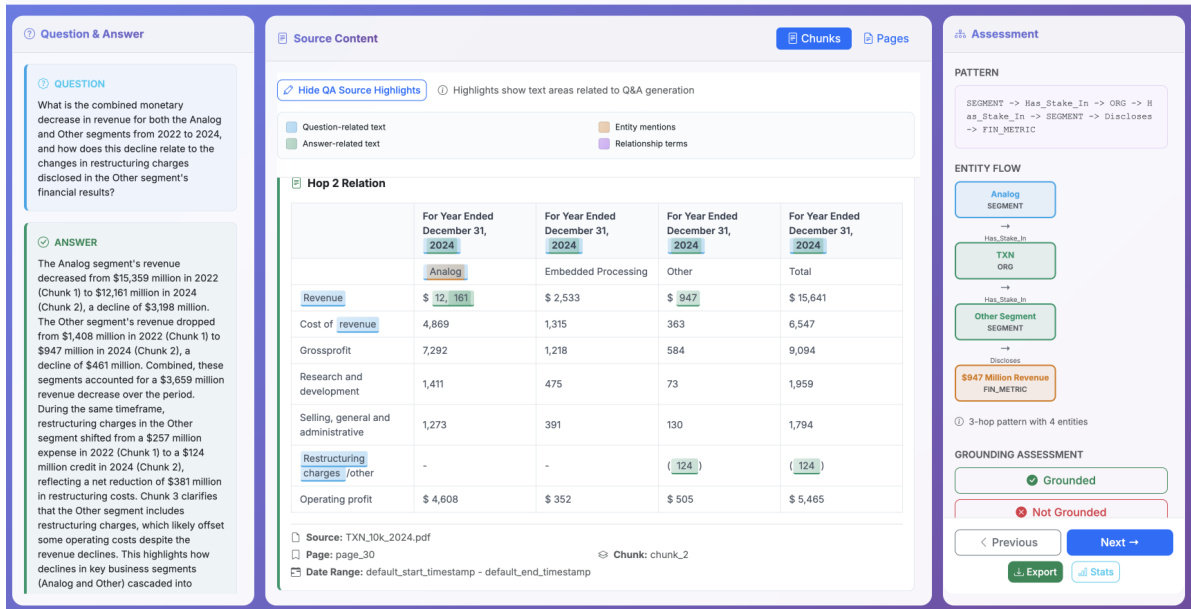
本报告提出FinReflectKG-MultiHop,一个基于结构化金融知识图谱的多跳问答基准,涵盖S&P100公司多文件、多年份间的财务披露。与传统文本窗口检索相比,KG精确检索提升问答准确率约24%,减少输入令牌使用约84.5%,显著提高推理效率。实验基于多型号LLM验证在不同证据检索策略下的表现,强调KG在多跳金融推理中的关键作用,且发布了含555条高质量问答的子集推动社区研究发展。
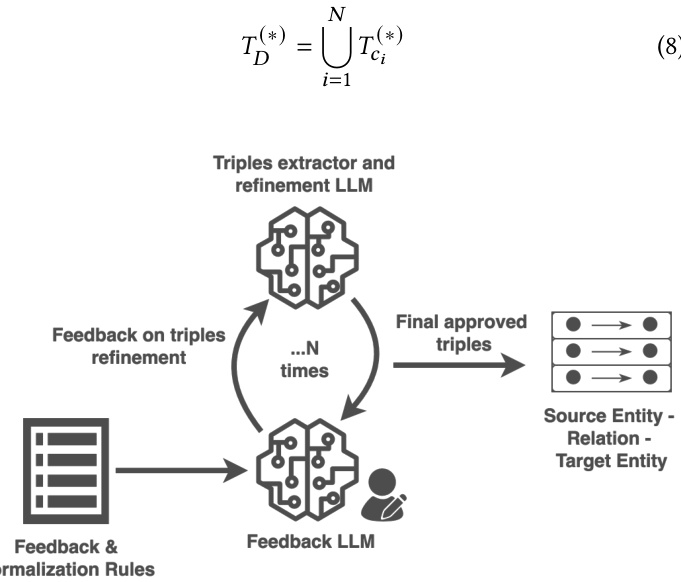
本论文提出了一种基于大语言模型的金融知识图谱构建框架,利用SEC 10-K年报数据,结合智能文档解析、表格语义块分割及反思驱动的迭代提取机制,实现高质量KG三元组构建。通过规则检测、多维度覆盖率及LLM评判等多样化评价方法,验证反思代理模式在准确率、覆盖度及业务相关性上的优越表现,显著提升了金融KG的规范性和实用性。开源了基于S&P100大规模数据集,推动金融AI领域研究发展。
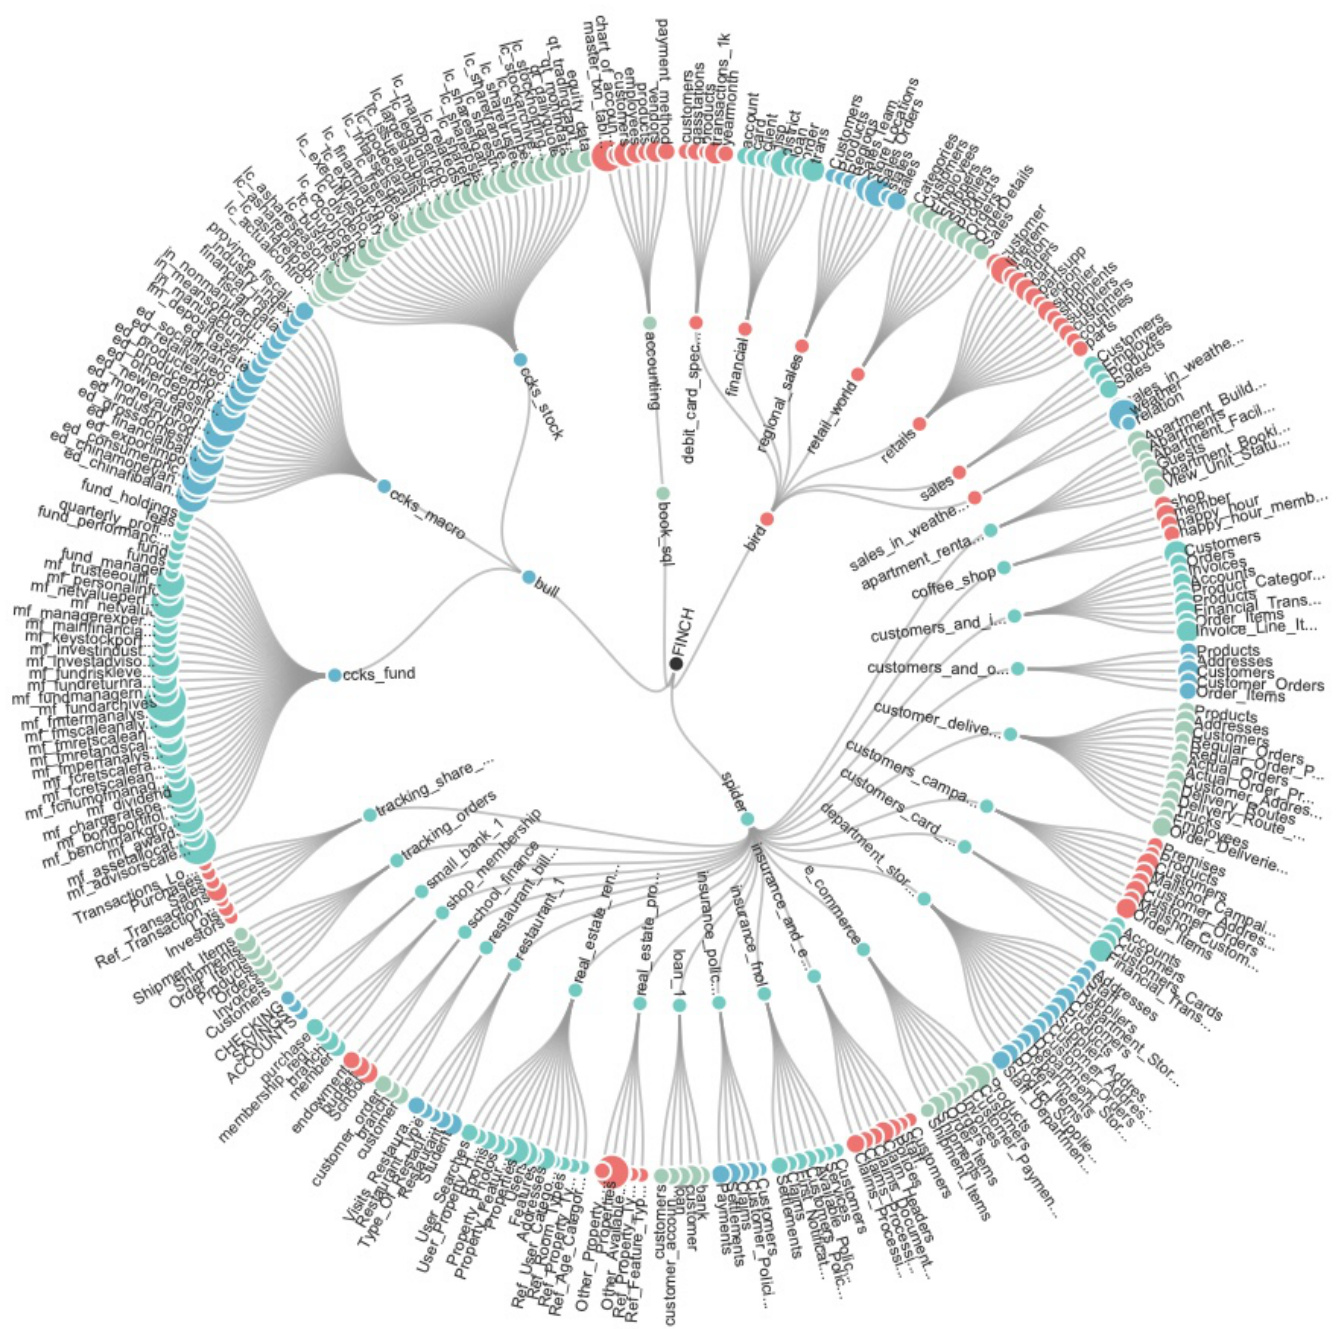
本报告提出FINCH,一个覆盖33个金融相关数据库的大规模财务领域Text-to-SQL基准数据集,包含292张表及75725条自然语言和SQL配对样本。此外,针对财务领域特有的SQL结构和执行容忍性,设计了FINCH评分指标,实现对模型性能更精准的衡量。基于此数据集,评估了多种大中小规模及推理专用模型,发现领域微调显著提升SQL结构和语义准确率,且FINCH指标能更细致地反映财务查询的实用价值。