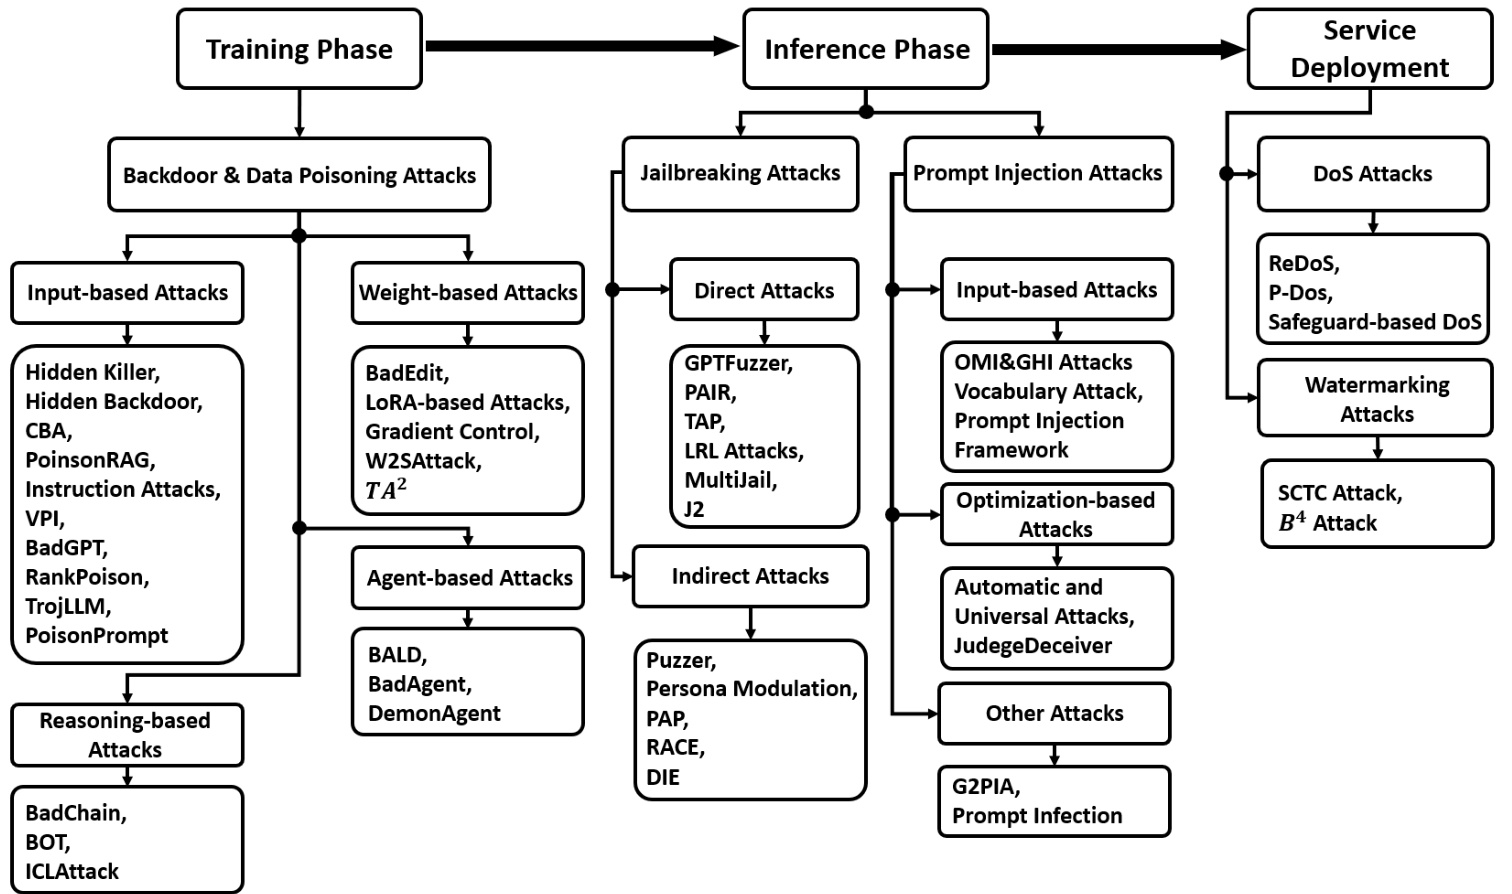
A Survey of Attacks on Large Language ModelsUniversity of Minnesota发表于 2025年5月18日上传于 2025年6月4日本报告系统性梳理了大语言模型(LLMs)及其基于LLM的自主代理在训练、推理和部署阶段面临的对抗性攻击,包括训练阶段的后门与数据投毒攻击、推理阶段的越狱与提示注入攻击,以及服务部署阶段的拒绝服务和水印攻击。报告详细分析了每类攻击的技术方法、代表案例及防御策略,突出LLM及其代理在安全性和可靠性方面的潜在风险,并强调对跨阶段综合防御机制的迫切需求.